Когда бизнес подключает AI-агента к вебу, слово free звучит очень приятно. Кажется, вот оно: агент сам читает сайты конкурентов, собирает цены, проверяет наличие товаров, готовит исследование для маркетолога.
А потом приходит счёт. И часто он не за сам поиск, а за то, что агент принёс языковой модели на чтение.
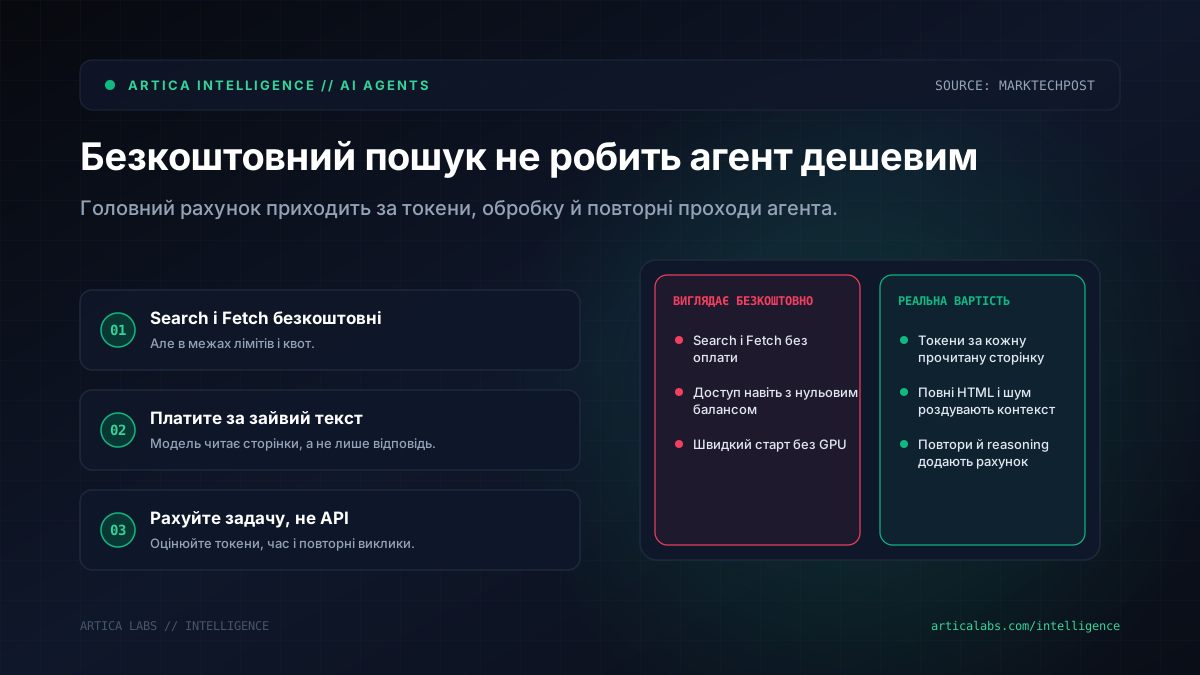
Как пишет MarkTechPost, TinyFish сделала Search и Fetch бесплатными в пределах лимитов. Но в этой истории есть вторая часть экономики: каждая страница, которую агент прочитал, превращается во входные токены для модели. Дальше добавляются reasoning, ответ модели и повторные проходы в агентном цикле. И вот тут начинается самое интересное.
Бесплатный запрос не делает задачу дешёвой автоматически
Теперь TinyFish даёт бесплатный Search в пределах 30 запросов в минуту и 500 в час. Fetch бесплатен до 150 URL в минуту и 1 000 в день. Оба работают даже при нулевом балансе Wallet.
Доступ есть через REST, Python и TypeScript SDK, CLI и MCP. Под капотом компания использует собственную инфраструктуру с браузерным флотом для рендеринга страниц и взаимодействия с сайтами. Локальный GPU для этого не нужен.
По срезу Artificial Analysis от 28 сентября 2026 года TinyFish Search получил 71 балл и показал $9.30 за 1 000 benchmark tasks, если считать модельную часть. Это самая низкая общая стоимость среди 12 показанных конфигураций.
Но есть нюанс. Результат 71 был самым низким среди отображённых систем, тогда как Perplexity Search medium показал 80. Время на задачу у TinyFish составило 59 секунд — это второй по длительности показатель в таблице. То есть дёшево, но не всегда быстро и не всегда с лучшим качеством.
Есть ещё одно ограничение: в продукте Agent встроенную модель TinyFish нельзя заменить. Для части команд это нормально. Но если вы хотите тонко подбирать модели под разные задачи, придётся принять этот компромисс.
Больше всего денег съедает не поиск, а лишний текст
MarkTechPost приводит показательный пример из теста TinyFish на 45 URL. Для одной статьи Daily Mail с телом примерно 4 300 символов разные провайдеры вернули очень разный объём текста.
TinyFish Fetch отдал 4 737 символов, примерно 1 184 токена. Firecrawl Scrape вернул 171 095 символов, ориентировочно 42 774 токена. Exa Contents и Tavily Extract тоже отдали значительно больше: 65 793 и 46 433 символа соответственно. Parallel Extract вернул лишь фрагмент на 600 символов, поэтому напрямую сравнивать его с полными извлечениями было бы нечестно.
Это один сайт, а не универсальный закон. Но для бизнеса вывод простой: если агент тащит меню, комментарии, рекламу, футеры и технический шум, вы платите модели за чтение мусора.
Представим интернет-магазин, который каждый день проверяет цены конкурентов. Если агент забирает полные страницы товаров без очистки, контекст забивается очень быстро. Страница на 42 774 токена занимает примерно треть окна в 128K. Три такие страницы — это уже около 128 322 токенов, почти без места для инструкций, истории диалога и ответа.
Мы бы начинали не с выбора самого дешёвого API, а с нескольких приземлённых проверок:
- посчитать средний размер страницы после Fetch: символы, токены, долю полезного текста;
- не передавать модели полные HTML-страницы, если достаточно цены, заголовка, описания или таблицы;
- тестировать провайдера на своих сайтах, потому что новости, маркетплейсы и B2B-каталоги ведут себя по-разному;
- считать стоимость задачи, а не цену одного API-запроса;
- проверять лимиты и задержку, особенно для процессов в реальном времени.
Для агентства это может означать более дешёвое исследование рынка. Для клиники — мониторинг регуляторных обновлений. Для службы доставки — проверку страниц партнёров. Сценарии вполне нормальные, но мы бы не ставили такой инструмент в продакшн без небольшого пилота: 50–100 типовых задач, замер токенов, времени, качества ответа и количества повторных вызовов.
Бесплатный поиск — это приятно. Но настоящая экономия начинается там, где агент читает меньше лишнего и точнее извлекает нужное.