Если ваш бизнес разрабатывает MVP, SaaS или даже внутреннюю CRM, скорость команды зависит не только от написания кода. Часто всё стопорится на ревью. Разработчик уже закрыл задачу, а изменение ждёт проверки день, два, иногда неделю.
Для владельца бизнеса это звучит как техническая мелочь. На деле последствия очень приземлённые: релизы сдвигаются, баги накапливаются, команда тратит часы на ручную рутину вместо того, чтобы двигать продукт вперёд.
И вот тут начинается самое интересное. AI в code review уже не сводится к сценарию «загрузили файл в чат и спросили, всё ли хорошо». Как пишет DOU, команды тестируют схемы, где один агент пишет код, другой проверяет, третий оценивает качество замечаний, а тесты запускаются ещё до pull request.
AI-агенты уже подстраховывают ревьюеров
Причина проста: кода становится больше. В GitLab, по данным DOU, поставили цель выйти на 500 merge request’ов на инженера в месяц к концу года. Это не обязательно про то, чтобы «выжимать больше из людей». Скорее про попытку убрать трение там, где оно съедает дни. Ведь один MR иногда смотрят от двух до десяти человек.
В Kube-DC масштаб другой: проект на 1,2 млн строк кода, над которым работали трое вместо запланированных 15. Основатель Kube-DC Владимир Цап описал цикл, где одна модель писала и тестировала код, другая искала проблемы, первая исправляла, и так по кругу. Для сложного core-компонента таких повторов было около 140 за три дня. Человек, скорее всего, устал бы гораздо раньше.
Но AI не отменяет здравый смысл. Он хорошо ловит механику: несоответствие правилам, крайние сценарии, проблемы в тестах, нарушения внутренних конвенций. Представим интернет-магазин. Агент может проверить, не ломает ли новая логика промокодов оплату. Или клинику: не открывает ли изменение в админке лишние данные пациента. Но вопрос, нужна ли эта фича бизнесу именно сейчас, модель за владельца продукта не решит.
Готовый сервис или собственный агент: зависит от зрелости команды
В статье DOU есть показательный контраст. В GitLab взяли встроенного AI-ревьюера и добавили локальные этапы проверки. В Preply сравнивали собственного ревьюера с готовыми решениями на одинаковых pull request. В одном тесте было семь намеренных нарушений внутренних DDD-правил: собственный ревьюер нашёл все семь, CodeRabbit показал три в обычных комментариях, а ещё четыре отметил как minor.
Для бизнеса вывод довольно практичный. Если у вас небольшая команда или продукт только стартует, начинайте с готовых инструментов. Не нужно в первый месяц строить «свой GitLab Copilot». Сначала посмотрите, где именно болит: после релиза вылетают баги, ревью долго висит без движения, код пишут в разных стилях, тесты покрывают не всё.
Минимальный план может быть таким:
- взять 20–30 старых pull request с известными проблемами и прогнать на них AI-ревьюер;
- не поручать LLM то, что лучше делают линтеры, типизация и автотесты;
- описать правила команды в гайдлайнах и давать агенту только нужный контекст;
- запускать проверки одинаково локально и в CI, например через подход local parity, который в источнике связывают с Dagger;
- сравнивать готовые решения с собственными прототипами на тех же задачах.
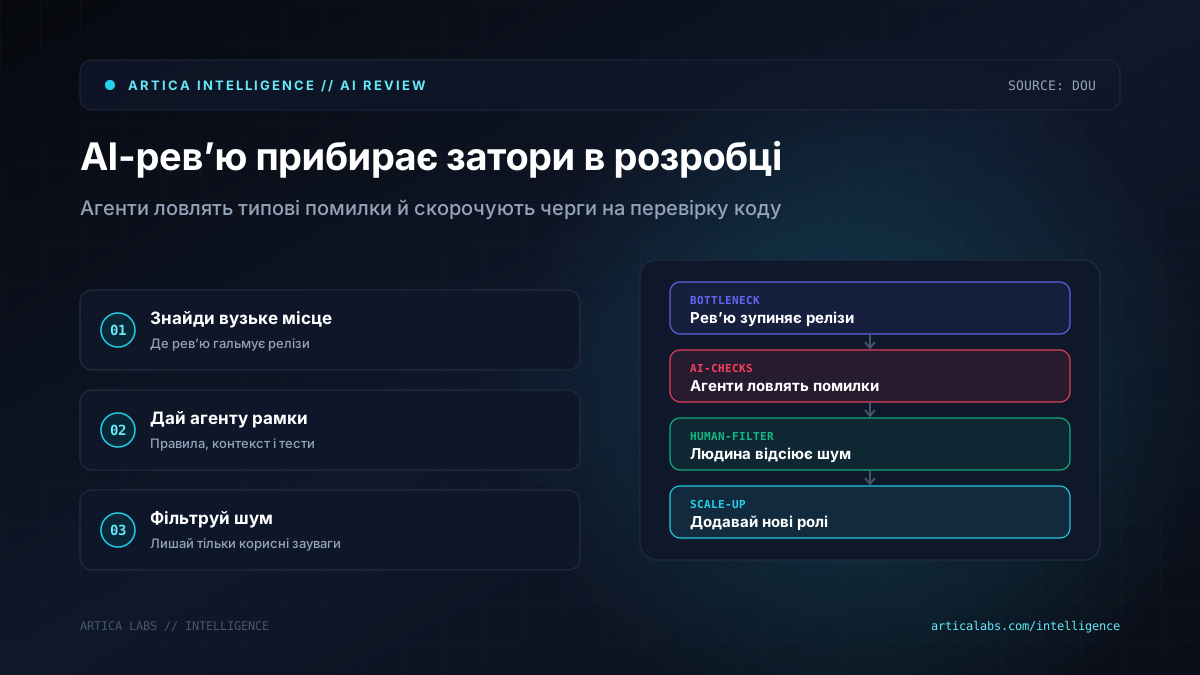
Подводный камень здесь один, но неприятный: шум. Когда агентов становится много, они начинают находить всё подряд. Стилистические придирки. Риски, которых может и не быть. Дубликаты одних и тех же замечаний разными словами.
Поэтому нужен фильтр. Это может быть главный агент, который отсеивает лишнее, или человек, который смотрит только на финальный набор комментариев. Иначе команда быстро перестанет читать эти подсказки, даже если среди них есть действительно полезные.
Наша позиция проста: AI-ревью имеет смысл не как модная игрушка для разработчиков, а как способ убрать заторы в доставке продукта. Начните с малого: один агент, один тип проверок, один репозиторий. Когда станет видна польза и границы, можно добавлять роли для security, архитектуры, базы данных или интерфейса. Так AI встраивается в процесс, а не превращается в ещё один хаотичный чат рядом с командой.