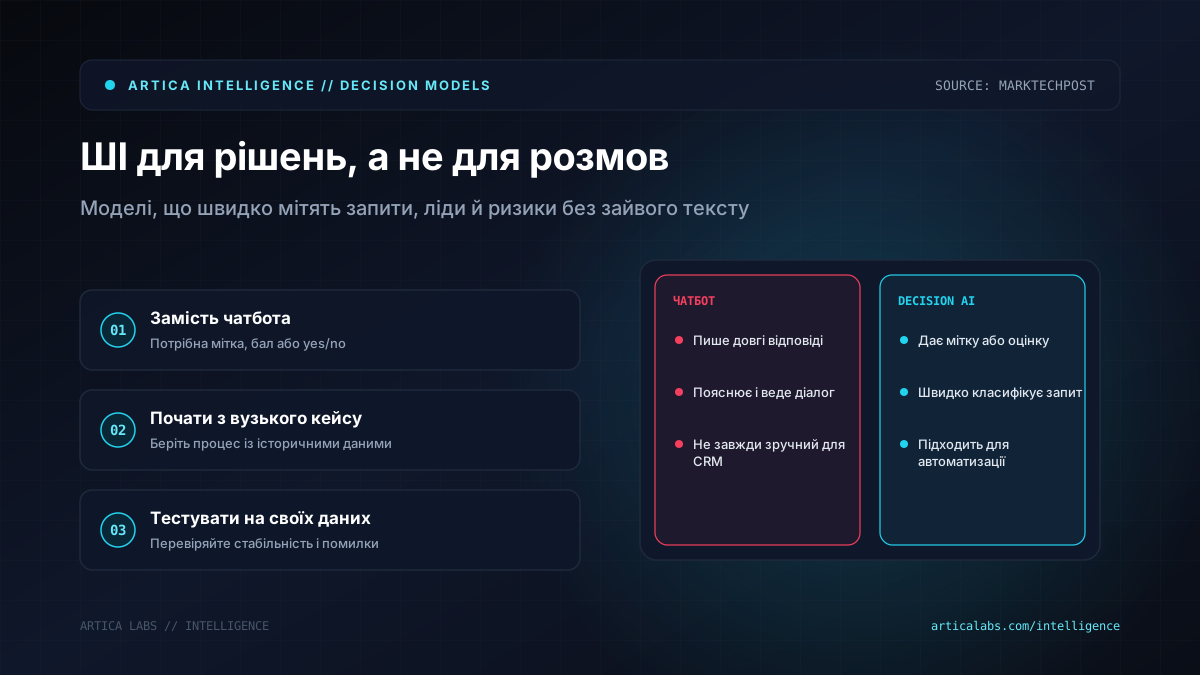
Бизнесу не всегда нужен чатбот, который умеет красиво объяснять. Чаще нужна система, которая быстро ответит: этот запрос срочный или нет, лид горячий или холодный, платеж подозрительный или обычный. Без длинных абзацев и «человеческого тона». Просто решение, которое можно передать в CRM, службу поддержки, кабинет врача или складскую систему.
Именно поэтому вокруг decision models сейчас так много движения. MarkTechPost пишет, что после запуска TypeSafe Jev 15 сентября 2026 года примерно за четыре недели появилось как минимум 20 альтернатив. И вот тут начинается самое интересное. Речь уже не о том, чтобы «поговорить с AI», а о том, чтобы дать модели набор разрешенных ответов и получить метку, балл или вероятность «да/нет».
AI, который не болтает, а ставит метки
Jev от TypeSafe работает как модель для типизированных решений. Вы передаете ей состояние — например, тикет клиента или строку лога — и задаете вопрос в формате Choice, Score или yes/no. Модель не пишет текст, а оценивает варианты.
У Jev контекст 64k токенов, цена в документации — $0.042 за 1 млн входных токенов, выход не тарифицируется. Но есть и ограничения: только текст, закрытые веса, доступ через waitlist, нет опубликованного размера модели, self-hosting и fine-tuning.
Альтернативы пытаются закрыть эти пробелы. Cloudflare Clef и Clef-flash работают через Workers AI, принимают текст, JSON и до 4 изображений в запросе. Perplexity pplx-decider читает текст, JSON и до 8 изображений на вопрос, а flash-версия стоит $0.01 за 1 млн входных токенов. OpenAI выпустила Decisions API в публичной бете, но без совместимости с Jev API и без опубликованных бенчмарков.
Есть и open-source-направление. Strands Decider от AWS Strands Labs можно поднять локально, Kev имеет варианты от 0.8B до 27B, Mapika Decider доходит до 35B-A3B, а более легкие модели вроде Von, Laya или GLiNER2.5-Decide интересны для CPU или edge-сценариев. Разброс большой: от 287M параметров до 35B-A3B. Выборов уже не один. Но и простого «берем самое новое» здесь тоже нет.
Где это может сработать в реальном процессе
Представим интернет-магазин. Модель может разложить обращения по типам: возврат, гарантия, доставка, жалоба. Не отвечать клиенту вместо оператора, а передать метку в helpdesk и выставить приоритет.
В клинике такая модель может предварительно определить тип обращения пациента по описанию симптомов и направить его к нужному администратору. В агентстве — оценивать лиды по вероятности покупки. В службе доставки — отмечать рискованные инциденты в операционных логах.
Практический старт мы видим так:
- взять один узкий процесс, где уже есть исторические данные и правильные ответы;
- сравнить 2–3 модели на собственной выборке, а не на красивых vendor-бенчмарках;
- проверить стабильность: меняется ли ответ от порядка опций или формулировки;
- оставить человека в цикле там, где ошибка стоит дорого.
Подводные камни здесь серьезные. MarkTechPost прямо напоминает, что большинство результатов в таблицах — self-reported. В стороннем прогоне Respan Jev показал accuracy 0.932, Tev1 — 0.901, Kev — 0.833, а Laya и Von заметно просели. Но и этот тест делал поставщик конкурирующей модели. То есть как ориентир это полезно, как истина — нет.
Самый большой риск для бизнеса в другом: модель возвращает результат в правильном формате, но по сути ошибается. Автоматизация выглядит аккуратно, отчеты собираются, процесс вроде бы работает. А потом оказывается, что горячие лиды уходили не туда, жалобы клиентов получали низкий приоритет, а подозрительные платежи проходили как обычные.
Поэтому decision models лучше запускать не как магическую кнопку, а как контролируемый слой в n8n, Make, CRM или внутреннем SaaS. С логами, тестами, порогами уверенности и ручной проверкой на старте.
Наша позиция проста: это сильный инструмент для операционной автоматизации, особенно там, где бизнесу нужны не тексты, а решения. Но покупать название модели не надо. Покупайте проверенный результат на своих данных.