Для бизнеса эта новость интересна не очередной гонкой бенчмарков. Суть в другом. AI-агенты, которые умеют работать с кодом, инструментами и длинным рабочим контекстом, постепенно выходят из закрытых экосистем в открытый доступ. А значит, у SaaS-команд, агентств автоматизации, внутренних IT-отделов и компаний, которые не хотят зависеть от одного провайдера, появляется больше вариантов.
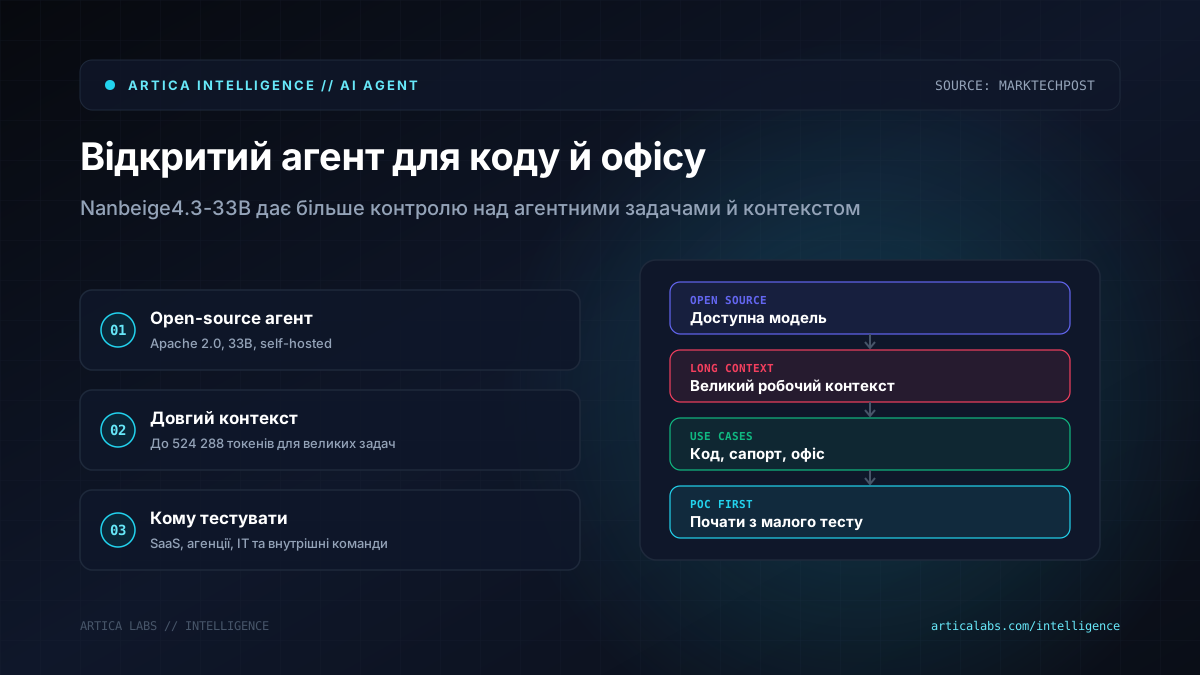
Как пишет MarkTechPost, Nanbeige LLM Lab опубликовала на Hugging Face модель Nanbeige4.3-33B под лицензией Apache 2.0. Лаборатория работает внутри рекрутинговой платформы BOSS Zhipin. У модели 33 млрд параметров, плотная архитектура без MoE, и она создана для agentic coding и офисных задач в формате «AI-сотрудника». Также доступна базовая версия Nanbeige4.3-33B-Base для кастомного дообучения.
Длинный контекст — это не магия, но для работы полезно
Nanbeige4.3-33B поддерживает контекстное окно 524 288 токенов. Простыми словами, в модель можно загрузить очень большой объем рабочей информации: репозиторий, документацию, логи, инструкции, историю задач. Для команды разработки это шанс лучше работать с большими кодовыми базами. Для операционного менеджера — получить агента, который видит не одно письмо или тикет, а более широкий кусок процесса.
Представим службу доставки. Есть заявки, статусы, шаблоны ответов, правила компенсаций и внутренние SOP. Агент с большим контекстом теоретически может не только ответить клиенту, но и проверить логику действий, предложить изменение в процессе или подготовить инструкцию для оператора. В клинике похожий сценарий может касаться внутренних регламентов записи и коммуникации с пациентами. В агентстве — анализа технического задания, CRM-процесса и кода интеграции.
По данным Nanbeige, модель лидирует в 17 из 20 строк собственного сравнения с открытыми моделями примерно на уровне 30B. На Terminal-Bench 2.1 она набрала 80.9 против 73.0 у Qwen3.8-27B. На Automation Bench — 54.2 против 38.3, на JobBench — 44.8 против 34.5. Есть и слабые места. На SWE-Bench Pro Nanbeige4.3-33B уступает Qwen3.8-27B: 60.3 против 61.7. А Terminal-Bench 4.0 показал 23.8 — это самый низкий результат модели в приведенной таблице.
Кому имеет смысл тестировать Nanbeige4.3-33B уже сейчас
Прежде всего эта модель интересна техническим командам, которые уже работают с self-hosted LLM или по причинам безопасности и контроля хотят держать данные ближе к собственной инфраструктуре. Например, SaaS-стартапу, который хочет поэкспериментировать с кодовым агентом для pull request, автотестов или миграций. Или компании, которая строит внутреннего помощника для сценариев n8n/Make, документации и технической поддержки.
И вот тут начинается самое интересное. 33B dense-модель — это не история из серии «запустили на ноутбуке и поехали». В рецептах для SGLang и vLLM упоминается 4-way tensor parallelism, то есть multi-GPU серверы. BF16-веса, по расчетам MarkTechPost, требуют примерно 66 ГБ памяти. Длинный контекст тоже имеет свою цену: чем больше токенов и параллельных сессий, тем быстрее растет потребление памяти.
Есть еще один нюанс. Все результаты в таблице Nanbeige — self-reported. Это не значит, что им нельзя доверять. Но для бизнес-решения этого мало. Мы бы начинали не с миграции процессов, а с небольшого теста:
- взять 2–3 реальные задачи из кода, поддержки или операционки;
- сравнить Nanbeige с моделью, которую команда уже использует;
- оценить не только качество ответа, но и скорость, стоимость инфраструктуры и стабильность tool calling;
- отдельно проверить, как модель ведет себя на длинных диалогах и не тащит ли ошибки из предыдущего контекста.
Nanbeige также позиционирует 33B-модель как «teacher» для будущей Nanbeige4.3-3B. Если меньшая версия унаследует часть агентных навыков, она может оказаться интереснее для массового бизнеса. Пока же Nanbeige4.3-33B выглядит как сильный инструмент для R&D, технических команд и компаний, которые уже готовы платить за инфраструктуру и контроль.